Entendendo Arquitetura de Software
Refatorando um endpoint de criação de usuários em componentes com limites claros para facilitar novos pontos de entrada, regras de negócio e integrações.
O que uma API de backend realmente é?
É importante entender o que há por trás de uma API. Para tomar boas decisões como engenheiro de software, você precisa deixar de enxergar a API como uma caixa-preta na sua linguagem e no seu framework favoritos, que retorna e persiste os dados que você precisa. É preciso entender os componentes que fazem tudo isso funcionar.
Talvez você já se sinta confortável sabendo que uma API que recebe POST /users faz basicamente isto:
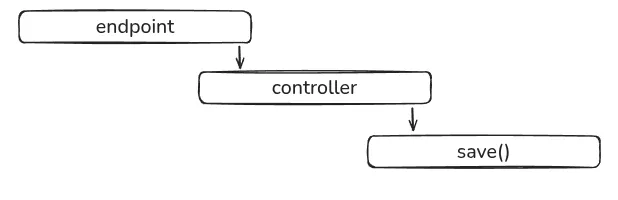
Essa visão ainda é limitada. Para tomar boas decisões de arquitetura, precisamos olhar para o caminho inteiro.
O fluxo é mais ou menos assim:
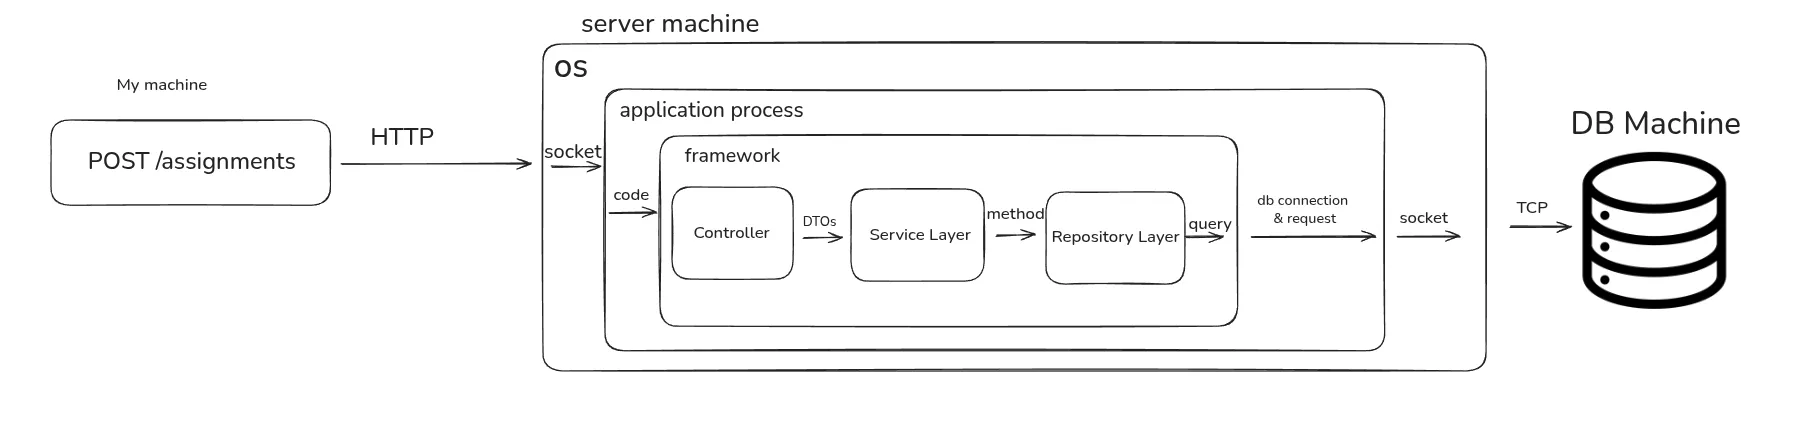
O diagrama usa POST /assignments como exemplo; o mesmo caminho por esses componentes se aplica a POST /users.
Uma requisição passa por vários componentes antes de chegar ao seu código: o controller, o service e o repository.
- O sistema operacional recebe a requisição HTTP e a encaminha para o processo da API.
- O processo da aplicação recebe essas requisições e as transforma em objetos da linguagem, como um objeto de requisição de servlet em Java.
- Esse objeto reúne atributos de HTTP e de rede. Os dados de que a API precisa são apenas uma parte dele. Um exemplo é a interface HttpServletRequest.
- O framework recebe esses objetos e os direciona ao código da aplicação, como o método do controller associado àquela URI.
- O controller recebe os dados esperados sem precisar desserializar a requisição HTTP por conta própria. No diagrama, ele delega a operação à camada de serviço.
- A camada de serviço executa a operação e aplica as regras de negócio.
- O repository interage com o estado persistente, tanto para consultar quanto para gravar dados.
- Se o controller é o conector de entrada, que recebe dados das requisições, o repository é o conector de saída, que inicia a troca de dados com o armazenamento.
Vale a pena investigar cada componente desse diagrama na linguagem, no sistema operacional e no framework que você usa. É interessante entender como as peças se conectam. A ideia principal aqui é:
Um sistema é formado por partes que cooperam, cada uma responsável por uma parte do comportamento.
É relativamente fácil entender as responsabilidades das peças externas ao nosso código: o sistema operacional, o processo da aplicação e o framework. Mas talvez ainda não esteja claro por que dividimos o código da API em outros três componentes.
Cada componente externo tem limites bem definidos: interagir com o sistema operacional, transformar uma requisição HTTP em dados da aplicação e assim por diante. Além disso, essas peças já existem. Dentro da API, somos nós que precisamos definir os limites e as responsabilidades. É aí que as coisas começam a ficar menos claras.
Por que não escrever tudo no controller?
Nosso endpoint POST /users tem uma tarefa bem definida: criar um usuário.
Vamos supor que ele espere este payload:
{
    "name": "John Doe",
    "email": "arthurcarvalhorodrigues@gmail.com",
    "age": 18,
    "bio": "I like to cook and travel."
}
É a v1, e já sabemos que aceitaremos mais campos no futuro.
Temos algumas regras:
name,emaileagesão obrigatórios.bioé opcional.- O email não pode estar associado a outro usuário.
- O usuário deve ter mais de 12 anos.
Parece simples: três verificações, sem um algoritmo complexo.
Para um endpoint pequeno, colocar tudo em um método pode parecer razoável. Vamos ver em que momento essa escolha começa a atrapalhar.
    @PostMapping
    public ResponseEntity<?> createUser(@RequestBody Map<String, Object> payload) {
        String name = (String) payload.get("name");
        String email = (String) payload.get("email");
        Integer age = payload.get("age") != null ? Integer.parseInt(payload.get("age").toString()) : null;
        String bio = (String) payload.get("bio");

        // 1. Verificar a presença dos campos
        if (name == null || name.isBlank() || email == null || email.isBlank() || age == null) {
            return ResponseEntity.badRequest().body("Nome, email e idade são obrigatórios.");
        }

        // 2. Regra de negócio: idade mínima
        if (age <= 12) {
            return ResponseEntity.badRequest().body("O usuário deve ter mais de 12 anos.");
        }

        // 3. Consultar o banco: email duplicado
        Integer count = jdbcTemplate.queryForObject(
            "SELECT COUNT(*) FROM users WHERE email = ?", Integer.class, email);
        if (count != null && count > 0) {
            return ResponseEntity.status(HttpStatus.CONFLICT).body("Email já cadastrado.");
        }

        // 4. Persistir
        jdbcTemplate.update(
            "INSERT INTO users (name, email, age, bio) VALUES (?, ?, ?, ?)",
            name, email, age, bio
        );

        return ResponseEntity.status(HttpStatus.CREATED).body("Usuário criado com sucesso.");
    }
No caminho sem erros, o endpoint faz o que precisamos. A conversão dos dados de entrada e as requisições concorrentes ainda exigem atenção, mas primeiro vamos ver o que acontece quando os requisitos crescem. A v2 chega com novas necessidades:
- Os usuários também enviarão suas preferências como uma lista de palavras-chave, que será usada para encontrar usuários com interesses parecidos.
- Precisamos de uma ferramenta de linha de comando para criar usuários em lote a partir de arquivos CSV.
- Precisamos enviar um email de boas-vindas para cada novo usuário.
Traduzindo isso em requisitos técnicos:
- Como um usuário tem várias preferências, precisamos de uma tabela separada para armazená-las. Criar um usuário passa a envolver duas tabelas. Essas gravações devem ter sucesso ou falhar juntas, então precisamos de uma transação.
- A ferramenta de linha de comando executa em um contexto diferente do servidor HTTP.
- Enviar emails envolve rede e comunicação externa. O que acontece se um envio falhar?
A ferramenta de linha de comando poderia chamar o endpoint HTTP, mas não consegue reutilizar essa lógica diretamente sem depender de HTTP ou duplicar o método. Acrescentar preferências e envio de email aqui misturaria ainda mais responsabilidades no controller.
Vamos pensar nos limites. A que esse endpoint está acoplado dentro do sistema? A tudo. É um método que concentra todas as etapas da criação de usuários. Ele conhece:
- HTTP
- Banco de dados
- SQL
- Regras de negócio
- Tratamento de erros
- Serialização
- Sistemas externos
Dizemos que esse controller tem alto acoplamento.
Acoplamento
Acoplamento é o quanto uma parte do sistema precisa conhecer outra.
Para reduzir esse acoplamento, separamos as responsabilidades em componentes.
Separação de responsabilidades
Até aqui, vimos os componentes de um backend e por que é importante reduzir o acoplamento entre eles.
Criar componentes com responsabilidades bem definidas também é chamado de separation of concerns, ou separação de responsabilidades. Cada componente cuida de uma preocupação do sistema.
O que faz de algo um componente útil?
Ele tem uma responsabilidade clara e uma interface clara pela qual o restante do sistema interage com ele.
No caso da criação de usuários, deixe um pouco de lado os nomes Controller, Service e Repository. Pense nas responsabilidades:
- Validação da entrada
- Lógica de negócio
- Persistência
- Comunicação externa
Do que a lógica de negócio deve cuidar?
- Verificar se o email já está cadastrado
- Validar a idade
- Construir o usuário e decidir quando uma notificação de boas-vindas é necessária
Do que ela não deve cuidar?
- Códigos de status HTTP
- JSON
- Sintaxe SQL
- Requisições de rede
Esses são os nossos limites. E podemos expressá-los por meio de interfaces.
Interfaces e dependências entre componentes
Na arquitetura, uma interface descreve o que um componente precisa de outro sem exigir que ele conheça os detalhes da implementação.
Vamos criar um componente chamado UserService para a lógica de negócio e outro chamado UserRepository para a persistência de usuários.
O UserService precisa verificar emails e gravar usuários. Ele não precisa conhecer conexões com o banco ou consultas SQL. Deve poder confiar que o UserRepository executará essas operações conforme o contrato estabelecido pela interface.
O UserService define que chamará o UserRepository por estes métodos:
- save(…): persiste o usuário.
- emailExists(email): retorna true se houver um usuário com esse email e false caso contrário.
Ter uma interface, por si só, não significa que os limites sejam bons.
Se criarmos uma interface PostgresUserRepository cujos métodos dependem de detalhes específicos do Postgres, quem a chama continua acoplado ao Postgres. E se mudarmos para MySQL? A troca do repository também exigirá mudanças nos serviços que o utilizam.
Por isso, usamos contratos como UserRepository. Se o contrato preservar o comportamento de que o serviço precisa, a mudança de Postgres para MySQL pode manter esse serviço intacto. Migrações e diferenças no comportamento das transações continuam exigindo trabalho, mas ficam dentro dos limites da persistência. Podemos ter implementações PostgresUserRepository e MySQLUserRepository e escolher qual usar por injeção de dependência.
A ideia é:
Direcione as dependências para conceitos estáveis quando essa separação trouxer valor.
Desacoplando nosso endpoint
Vamos dividir o endpoint em componentes coesos e com menos acoplamento. Lembrando os requisitos:
bioepreferencessão os únicos campos opcionais.emailnão pode estar associado a outro usuário.agedeve ser maior que 12.- A criação de usuários também deve funcionar pela linha de comando.
- Novos usuários devem receber um email de boas-vindas.
A partir disso, podemos definir os seguintes componentes:
| Componente | Categoria da responsabilidade | Do que cuida | O que não deve conhecer |
|---|---|---|---|
| User Controller (adaptador HTTP) | Transporte e protocolo | Semântica HTTP (status e cabeçalhos), serialização JSON e validação da estrutura de entrada (presença e formato dos campos). | SQL, esquema das tabelas, limites das transações e regras de negócio, como idade mínima. |
| User CLI (adaptador de lote) | Transporte e protocolo | Leitura de linhas CSV, interpretação de arquivos, códigos de saída e conversão de texto em comandos da aplicação. | HTTP, sockets de rede e consultas SQL. |
| User Service | Lógica de negócio e orquestração | Coordenação do caso de uso, aplicação das regras (idade e verificação de email), orquestração de efeitos externos e limites das transações. | Objetos de requisição e resposta HTTP, JSON, detalhes de conexão com o banco e protocolos de provedores de email. |
| User Repository (porta e adaptador) | Persistência e armazenamento | Abstração da persistência, mapeamento de objetos do domínio para gravações nas tabelas users e preferences, consulta de emails existentes e garantia de unicidade na gravação. | Semântica HTTP, políticas de negócio (como decidir se uma idade é válida) e lógica de notificações. |
| Notification Gateway (porta e adaptador) | Comunicação externa | Abstração do transporte externo (SMTP, SendGrid, Amazon SES) e comunicação de falhas de envio. A política de novas tentativas deve ser explícita. | Esquema das tabelas de usuários, fluxo do controller e regras de validação do domínio. |
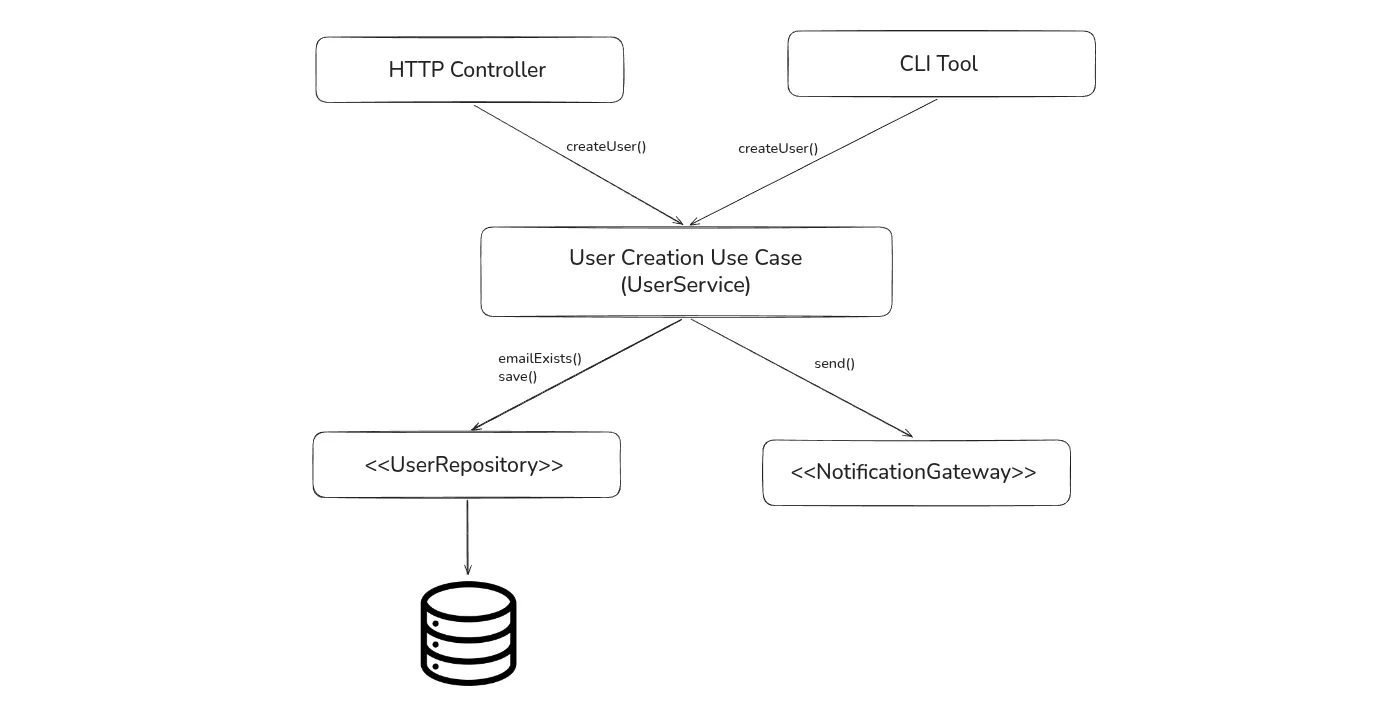
Acompanhando o fluxo após a refatoração
Os dois pontos de entrada agora constroem o mesmo CreateUserCommand. O controller HTTP obtém os valores do JSON; a CLI, de uma linha do CSV. Cada adaptador valida a estrutura da entrada e a converte para os tipos esperados pelo serviço. O serviço recebe um comando, sem depender de uma requisição HTTP ou de um arquivo aberto.
O caso de uso passa a ter uma sequência pequena e explícita:
- Aplicar a regra de idade e verificar se o email já está cadastrado.
- Construir o usuário, incluindo suas preferências.
- Persistir o usuário e as preferências em uma operação atômica.
- Solicitar a notificação de boas-vindas após o commit da transação.
- Retornar o usuário criado ou um erro significativo da aplicação para quem chamou.
O controller pode transformar um conflito de email em 409 Conflict; a CLI pode indicar a linha do CSV que apresentou o problema. Nenhum dos dois precisa decidir o que torna um usuário válido. Ambos usam a mesma decisão no UserService.
Neste caso de uso, UserRepository.save(user) pode garantir que o usuário e suas preferências sejam persistidos juntos, com a transação implementada pelo adaptador. Se um caso de uso futuro precisar de várias operações de repository na mesma transação, o serviço pode coordená-las por uma interface de unidade de trabalho. Os mecanismos de transação específicos do banco ficam por trás dessa interface.
Há dois detalhes que a simples divisão do código em classes não resolve.
Primeiro, emailExists permite retornar um erro claro antes da gravação, mas duas requisições podem passar por essa verificação antes que qualquer uma delas salve o usuário. O banco ainda precisa de uma restrição de unicidade sobre o email. O adaptador do repository transforma uma violação dessa restrição no mesmo conflito de aplicação que o serviço e seus chamadores entendem.
Segundo, gravar um usuário e enviar um email são operações separadas. Se o envio falhar depois do commit, a conta continuará existindo. Precisamos decidir se uma falha no email de boas-vindas é aceitável e como tentar o envio novamente. Enviar depois do commit evita notificar um usuário cuja transação foi desfeita, mas uma queda do processo entre o commit e o envio ainda pode perder a notificação. Se precisarmos garantir que a solicitação de envio sobreviva a uma falha, podemos gravar uma tarefa de notificação na mesma transação do usuário e deixar um worker fazer o envio. Esse worker também precisa de uma estratégia para novas tentativas e envios duplicados. Limites claros dão um lugar a essas decisões; não eliminam a necessidade de tomá-las.
O que fica mais fácil de mudar?
O resultado útil dessa refatoração é que cada requisito passa a ter um lugar mais previsível no código. Vamos retomar as mudanças que tornaram o controller original difícil de manter.
Adicionar outra forma de criar usuários
O importador de CSV se torna um adaptador do caso de uso existente. Ele interpreta uma linha, constrói um CreateUserCommand, chama o UserService e informa o resultado. Não precisamos copiar a validação de idade, a verificação de email ou o fluxo de persistência para uma segunda implementação.
Se depois aceitarmos cadastros por um consumidor de mensagens, ele também poderá chamar o mesmo serviço. Esses componentes podem viver na mesma aplicação e compartilhar uma biblioteca; separar responsabilidades não exige serviços de rede separados.
Mudar uma regra de negócio
Imagine que a idade mínima passe de mais de 12 para mais de 16 anos. Alteramos a política usada pelo UserService e seus testes. Os cadastros por HTTP e as importações CSV passam a aplicar a mesma regra, sem mudanças no SQL ou no envio de email.
Um novo campo de entrada tem um alcance maior: comando, adaptadores, modelo de domínio e armazenamento podem precisar mudar. A arquitetura não promete que toda funcionalidade alterará apenas um arquivo. Ela torna essas dependências explícitas, permitindo acompanhar a mudança sem procurar tudo em um controller que também concentra detalhes sem relação com ela.
Evoluir a persistência e as integrações
Se as preferências ganharem uma tabela própria ou sua estrutura de armazenamento mudar, o adaptador do repository cuida do mapeamento e das gravações atômicas. O serviço pode continuar salvando um usuário com preferências enquanto esse contrato atender ao caso de uso.
Trocar o provedor de email segue uma lógica parecida. Implementamos o contrato existente de NotificationGateway com o novo provedor e selecionamos essa implementação no ponto em que as dependências são conectadas. Autenticação do provedor, formatos de requisição e erros de rede ficam fora da política de criação de usuários. Uma mudança para envio por fila também exige um contrato claro sobre o significado de sucesso: aceitar uma tarefa é diferente de entregar um email.
Testar decisões sem iniciar o sistema inteiro
Podemos fornecer ao UserService um repository em memória e um gateway que registra as notificações solicitadas. Assim, verificamos que um usuário abaixo da idade permitida é rejeitado, que um email existente gera conflito e que uma falha ao salvar nunca solicita um email de boas-vindas, sem executar um servidor HTTP, um banco ou um provedor de email.
Esses testes não provam que as transações SQL ou as integrações com provedores funcionam. Ainda precisamos testar o repository real com um banco e os adaptadores de transporte conforme seus contratos. O benefício é conseguir investigar separadamente uma falha de regra de negócio e uma falha de integração.
Para fechar
Começamos com um controller que sabia receber uma requisição, validar um usuário, consultar o banco e persistir o resultado. Cada novo requisito trazia mais detalhes para o mesmo método. Depois da refatoração, o caso de uso de criação de usuários tem uma interface clara, e transporte, persistência e notificações têm responsabilidades próprias.
Isso nos dá uma forma prática de evoluir o sistema: reutilizar o caso de uso quando muda o ponto de entrada, ajustar a política quando muda uma regra e trabalhar no adaptador quando muda uma integração. Podemos raciocinar sobre uma parte menor do sistema e testar as suposições nos seus limites.
Há um custo: mais componentes, contratos e conexões para manter. Uma interface justifica sua existência quando separa uma responsabilidade relevante ou uma dependência que precisamos controlar. Neste exemplo, o endpoint HTTP, o importador CSV, as gravações relacionais e o provedor de email já são motivos concretos para esses limites.
Quando chegar o próximo requisito, pergunte: qual responsabilidade deve cuidar dele, e o contrato atual ainda descreve o que precisamos? Essa pergunta é mais útil do que escolher primeiro uma estrutura de pastas. Ela mantém a arquitetura ligada ao comportamento que estamos construindo e às mudanças que esperamos fazer.